
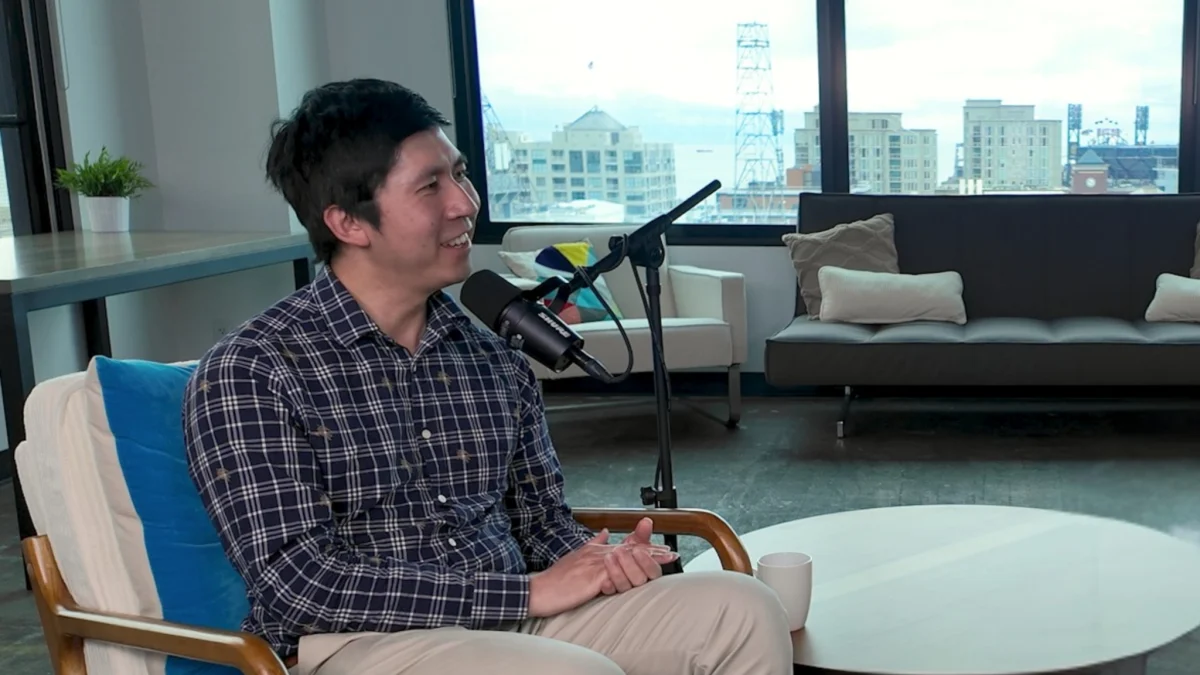
Palo Alto merkezli yapay zeka girişimi Elorian, ilk modeli Glimpse'i cuma günü araştırma önizlemesi olarak kullanıma sundu. Gelişmeyi TechCrunch özel haber olarak duyurdu. Model, API erişimi ve sohbet arayüzü ile birlikte geliyor. Şirket, ürününü piyasaya sürmeden önce 300 milyon dolar değerleme üzerinden 55 milyon dolarlık tohum yatırım almasıyla dikkat çekmişti.
Haberin özünde Elorian'ın tezi yer alıyor: Bugünün yapay zeka modelleri dil ve kod konusunda yetenekli olsa da gerçekten göremiyor. Çoğu çok modlu model bir görsele bir kez bakıp onu tokenlara dönüştürüyor ve ardından metin üzerinden akıl yürütüyor; bu da bir fotoğrafı hafızadan tarif etmeye benzetiliyor. Glimpse ise kaynağa geri dönmeye devam ediyor.
TechCrunch'ın özel olarak öğrendiği lansman, şirketin gizlilikten çıkmasından yaklaşık altı ay sonra gerçekleşti. Elorian altı ay önce gizlilikten çıkmış ve Striker Venture Partners, Menlo Ventures ve Altimeter Capital'in ortak liderliğinde bir yatırım turunu duyurmuştu. Tura Nvidia ve Google baş bilim insanı Jeff Dean'in de katıldığı aktarıldı.
Bu işleyiş, telefon fotoğrafında bir detayı kontrol etmek için parmakla yakınlaştırma hareketine benzetiliyor. Kaynak metinde, çoğu modelin görseli bir kez tokenlara çevirip metin üzerinden akıl yürütmesine karşın, Glimpse'in görsel kaynağı tekrar tekrar incelemesi arasındaki fark vurgulanıyor.
Yaklaşımın tamamen yeni olmadığı da kaynakta not ediliyor. OpenAI'nin 2025 yılında o serisi modellerine akıl yürütme sırasında kırpma ve yakınlaştırma özelliği eklediği hatırlatılıyor. Elorian'ın iddiası ise tüm modeli bu yetenek etrafında ve düşük maliyetle inşa ettiği yönünde.
Dai, TechCrunch'a yaptığı açıklamada kutu oyunlarının her birinin kendi görsel diline, ikonografisine ve sembollerine sahip olduğunu söyledi. Yetişkin bir insanın minimal metinle bile oyunda neler olduğunu kolayca anlayabildiğini, ancak bu modellerin sembollerin ne anlama geldiğini sezgisel olarak kavrayamadığını ifade etti.
Dai'nin bir diğer benzetmesi Ikea diyagramları oldu. "İnsanlar hiç metin içermeyen Ikea diyagramlarına bakıp Ikea mobilyalarını kurabiliyor, değil mi? Peki yapay zeka modelleri neden yapamıyor?" sözleri kaynakta doğrudan alıntı olarak yer aldı.
Fiyatlandırma tarafında Glimpse'in milyon token başına 0,60 dolar giriş ve 3 dolar çıkış ücretiyle sunulduğu bildirildi. Bu fiyatın Sonnet ve Sol gibi orta seviye modellerden daha ucuz, Haiku ve Luna gibi hafif modellere göre ise daha pahalı olduğu ifade edildi.
Elorian'ın kendi değerlendirmelerine göre Glimpse, bilimsel grafik akıl yürütme ve kısa video altyazılandırma alanlarında GPT-6 Astra'yı bile geride bırakıyor. Diğer görsel akıl yürütme görevlerinde ise rekabetçi sonuçlar elde ettiği aktarılıyor. Bu sonuçların şirketin kendi değerlendirmelerine dayandığı özellikle vurgulanıyor.
Daha uzun vadede şirketin "görmekten yapmaya" geçmeyi hedeflediği belirtiliyor. Bu plan, bir sahnenin modelini oluşturup bunu bir eylem seçmek için kullanmayı içeriyor ve doğrudan robotları kontrol etmeyi de kapsıyor.
Gelecek yıla ilişkin hedefi ise Dai açıkladı. Dai, gelecek yıl "dünyanın en iyi görsel akıl yürütme modelini" inşa etmeyi amaçladıklarını ve her görsel akıl yürütme testinde lider olan bir model ortaya koymak istediklerini söyledi.
Haberin özünde Elorian'ın tezi yer alıyor: Bugünün yapay zeka modelleri dil ve kod konusunda yetenekli olsa da gerçekten göremiyor. Çoğu çok modlu model bir görsele bir kez bakıp onu tokenlara dönüştürüyor ve ardından metin üzerinden akıl yürütüyor; bu da bir fotoğrafı hafızadan tarif etmeye benzetiliyor. Glimpse ise kaynağa geri dönmeye devam ediyor.
Glimpse Araştırma Önizlemesi Olarak Tanıtıldı
Elorian'ın ilk modeli Glimpse, araştırma önizlemesi statüsünde piyasaya çıktı. Modelin hem API üzerinden hem de sohbet arayüzü aracılığıyla denenebileceği bildirildi. Şirketin Palo Alto merkezli olduğu ve ürün lansmanından önce 55 milyon dolarlık tohum turunu tamamladığı bilgisi kaynakta yer alıyor. Bu turdaki değerlemenin 300 milyon dolar olduğu belirtildi.TechCrunch'ın özel olarak öğrendiği lansman, şirketin gizlilikten çıkmasından yaklaşık altı ay sonra gerçekleşti. Elorian altı ay önce gizlilikten çıkmış ve Striker Venture Partners, Menlo Ventures ve Altimeter Capital'in ortak liderliğinde bir yatırım turunu duyurmuştu. Tura Nvidia ve Google baş bilim insanı Jeff Dean'in de katıldığı aktarıldı.
Görsel Çalışma Alanı ile Akıl Yürütürken Yakınlaştırma
Elorian'ın yaklaşımının merkezinde "visual scratch space" olarak adlandırılan bir mekanizma bulunuyor. Şirketin anlatımına göre Glimpse, akıl yürütme sürecinin ortasında kaynağa geri dönebiliyor. Bu sırada bir bölgeyi kırpıp yakınlaştırabiliyor, bir videodan belirli kareleri çekebiliyor veya baktığı şeyi ölçmek ya da karşılaştırmak için kod çalıştırabiliyor.Bu işleyiş, telefon fotoğrafında bir detayı kontrol etmek için parmakla yakınlaştırma hareketine benzetiliyor. Kaynak metinde, çoğu modelin görseli bir kez tokenlara çevirip metin üzerinden akıl yürütmesine karşın, Glimpse'in görsel kaynağı tekrar tekrar incelemesi arasındaki fark vurgulanıyor.
Yaklaşımın tamamen yeni olmadığı da kaynakta not ediliyor. OpenAI'nin 2025 yılında o serisi modellerine akıl yürütme sırasında kırpma ve yakınlaştırma özelliği eklediği hatırlatılıyor. Elorian'ın iddiası ise tüm modeli bu yetenek etrafında ve düşük maliyetle inşa ettiği yönünde.
Oyun Gecesinden Ikea Diyagramlarına Uzanan Örnek
Elorian CEO'su Andrew Dai, aynı zamanda eski bir Google DeepMind araştırmacısı. Dai'ye göre yapay zekanın hala gerçekten göremediğine dair en net işaretlerden biri bir oyun gecesinde ortaya çıktı. Dai, geçen yıl arkadaşlarıyla oynayıp bitirdiği bir kutu oyununun fotoğrafını çekti ve bir sınır modeline kimin kazandığını sordu. Modelin bu soruya yanıt veremediği aktarıldı.Dai, TechCrunch'a yaptığı açıklamada kutu oyunlarının her birinin kendi görsel diline, ikonografisine ve sembollerine sahip olduğunu söyledi. Yetişkin bir insanın minimal metinle bile oyunda neler olduğunu kolayca anlayabildiğini, ancak bu modellerin sembollerin ne anlama geldiğini sezgisel olarak kavrayamadığını ifade etti.
Dai'nin bir diğer benzetmesi Ikea diyagramları oldu. "İnsanlar hiç metin içermeyen Ikea diyagramlarına bakıp Ikea mobilyalarını kurabiliyor, değil mi? Peki yapay zeka modelleri neden yapamıyor?" sözleri kaynakta doğrudan alıntı olarak yer aldı.
Küçük Ekip, Az GPU ve Fiyatlandırma Detayları
Elorian, Glimpse'in küçük bir ekip tarafından birkaç yüz GPU üzerinde eğitildiğini ve modelin kıyaslandığı sınır sistemlerden önemli ölçüde daha küçük olduğunu belirtiyor. Şirketin bu vurgusu, modelin bütün mimarisini görsel akıl yürütme etrafında kurarken maliyeti düşük tutma iddiasıyla birlikte sunuluyor.Fiyatlandırma tarafında Glimpse'in milyon token başına 0,60 dolar giriş ve 3 dolar çıkış ücretiyle sunulduğu bildirildi. Bu fiyatın Sonnet ve Sol gibi orta seviye modellerden daha ucuz, Haiku ve Luna gibi hafif modellere göre ise daha pahalı olduğu ifade edildi.
Elorian'ın kendi değerlendirmelerine göre Glimpse, bilimsel grafik akıl yürütme ve kısa video altyazılandırma alanlarında GPT-6 Astra'yı bile geride bırakıyor. Diğer görsel akıl yürütme görevlerinde ise rekabetçi sonuçlar elde ettiği aktarılıyor. Bu sonuçların şirketin kendi değerlendirmelerine dayandığı özellikle vurgulanıyor.
Hedef Kitle ve Görmekten Yapmaya Geçiş Planı
Elorian'ın ilk etapta hedeflediği müşteri grupları, elinde çok miktarda video bulunan şirketler olarak sıralanıyor. Kaynakta bu gruplar arasında robotik firmaları, bilimsel laboratuvarlar, medya ve yaratıcı şirketler sayılıyor.Daha uzun vadede şirketin "görmekten yapmaya" geçmeyi hedeflediği belirtiliyor. Bu plan, bir sahnenin modelini oluşturup bunu bir eylem seçmek için kullanmayı içeriyor ve doğrudan robotları kontrol etmeyi de kapsıyor.
Gelecek yıla ilişkin hedefi ise Dai açıkladı. Dai, gelecek yıl "dünyanın en iyi görsel akıl yürütme modelini" inşa etmeyi amaçladıklarını ve her görsel akıl yürütme testinde lider olan bir model ortaya koymak istediklerini söyledi.
 Webmaster
 Webmaster
 Webmaster
Yorumlar (0)
Yorum yapmak için giriş yapmalısınız.