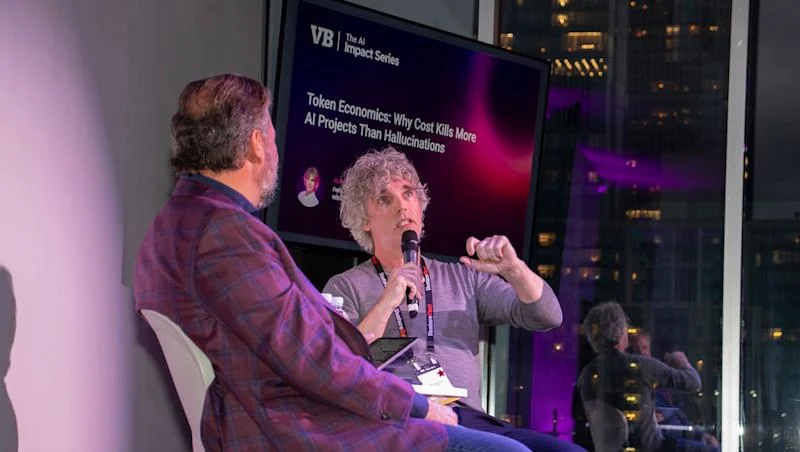
Büyük dil modellerini çalıştıran GPU'lar, zaten işledikleri bağlamı yeniden hesaplamak için kapasitelerinin yüzde 60'ına kadarını harcıyor olabilir. WEKA'nın Saha CTO'su Alan McSeveney, VentureBeat AI Impact Series etkinliğinde VentureBeat baş analisti Rob Strechay ile yaptığı konuşmada bu israfın kaynağını ve çözüm yollarını ayrıntılı biçimde açıkladı. McSeveney'e göre sorun, büyük dil modellerinin konuşma geçmişini GPU belleğinde tutma biçiminden kaynaklanıyor; bunu doğru yönetmek ise şirketlerin ellerindeki mevcut donanımla çok daha fazla kullanıcıya hizmet vermesini sağlıyor.
Bütçe, Güç ve Veri Merkezi Alanı Büyümenin Önünde
McSeveney, WEKA müşterilerinin altyapı katmanında en sık karşılaştığı darboğazların bütçe, güç erişilebilirliği ve veri merkezi alanı olduğunu vurguladı. "Bu kısıtlar şu anda pek çok kurumun büyüme çabalarının önüne geçiyor; dolayısıyla herkes halihazırda yaptığı sermaye yatırımından daha fazla verim almaya çalışıyor" dedi. Yapay zeka iş yükleri için kendi altyapısını kuran bir şirkette GPU'lar bütçenin yüzde 80'inden fazlasını alıyor; bu da yeniden hesaplama döngülerine harcanan her GPU saatini, McSeveney'in ifadesiyle, "muazzam bir para israfına" dönüştürüyor.
KV Önbellek Neden Yeniden Hesaplanıyor?
Çok turlu çıkarım sırasında GPU'lar, her değiş tokuşta aynı bağlamı yeniden hesaplamak zorunda kalmamak için işlenmiş bağlamı KV önbelleğinde saklıyor. Ancak GPU belleği sınırlı olduğundan eski bağlam silindiğinde, bir oturum yeniden başladığında GPU aynı geçmişi baştan hesaplamak durumunda kalıyor. McSeveney, bu durumu yönetecek herhangi bir strateji olmadan GPU kullanımının yeni iş için yüzde 30'a kadar düşebildiğini belirtti. İyi bir stratejiyle bu oranın yüzde 90'ın, en iyi koşullarda ise yüzde 95'in üzerine çıkabildiğini ekledi.
NVMe Flash, DRAM'e Karşı: Maliyet ve Ölçeklenebilirlik
Sektör, Mooncake ve DeepSeek'in son teknikleri ile Nvidia'nın Vera Rubin yığınına entegre edilmiş CMX bağlam bellek platformu dahil olmak üzere daha agresif KV önbellek yeniden kullanımı ve aktarımına doğru ilerliyor. McSeveney, NVMe flash'ın bu önbelleği tutmak için sunucu DRAM'ini genişletmekten daha ekonomik bir seçenek sunduğunu savunuyor. NVMe flash, KV önbelleğini tutma konusunda DRAM ile eşit ya da daha iyi performans gösterirken çok daha iyi ölçekleniyor ve çok daha düşük maliyete geliyor. "Veriyi mümkün olduğunca hızlı GPU'dan alıyorsunuz, başka birinin GPU'yu kullanmasına izin veriyorsunuz, ardından ihtiyaç duyulduğunda veriyi geri yüklüyorsunuz" diye açıkladı. Bu yer değiştirme hızı, tek bir GPU'nun kaç kullanıcıya hizmet verebileceğini doğrudan belirliyor. Sistem önbelleği yeterince hızlı taşıyabilirse her GPU dört ila beş kat daha fazla kullanıcıya hizmet verebiliyor.
WEKA'nın Artırılmış Bellek Izgarası: Merkezi KV Önbellek Yönetimi
WEKA'nın NeuralMesh depolama yazılımı üzerinde çalışan Augmented Memory Grid (Artırılmış Bellek Izgarası), GPU sunucularından KV önbelleğini alıp merkezi olarak depoluyor ve veri merkezindeki herhangi bir sunucuya geri yükleyebiliyor. Bu sayede bir oturum bir sunucuda duraksayıp başka bir sunucuda devam edebiliyor; ikinci GPU'nun geçmişi yeniden hesaplaması gerekmiyor. McSeveney, KV önbelleğini merkezi olarak yüklemenin DRAM'e aktarımla karşılaştırıldığında aynı GPU'lar üzerindeki kullanıcı sayısını 7 kat artırdığını ve aynı zaman diliminde çıktıyı 200.000 tokenden 2 milyona yükselttiğini aktardı. Bununla birlikte önbelleği optimize etmenin uygulamanın sorunlarını çözmediğini de vurguladı: "Uygulamanızı, iş akışınızı ve ardışık düzeninizi mümkün olduğunca optimize etmeniz gerekiyor" dedi.
GPU Sahipliği ve Token Başına Ücretlendirme Modeli
McSeveney, bu avantajın tescilli bir yığın kurmayı değil GPU'nun kontrolünü elinde tutmayı gerektirdiğini belirtti; bu durum hem kendi donanımını işleten hem de ham GPU örnekleri kiralayıp kendi yazılımını çalıştıran şirketler için geçerli. "Token başına ücret ödüyorsanız, karşı taraftaki önbelleklemenin büyük bölümünden elde edilen kazanım sizin değil onların cebine giriyor" dedi. Bu hesap, GPU arzının daralmasıyla birlikte daha da kritik bir hal alıyor. McSeveney, Google'ın müşterilerine ilettiği mesajı da örnek gösterdi: Google Cloud için sipariş edilen ancak henüz kurulmamış her GPU'nun hizmet ömrü boyunca zaten bir alıcısı var ve Aralık ayına kadar rezervasyon yaptırmayan müşteriler talep üzerine kapasite bulmayı beklememeli. McSeveney, "Kendi altyapınızın bir bölümünü işletmek ilk aklınıza gelen şey olmayabilir" dedi, "ama bir zorunluluk haline gelebilir."
Sıkça Sorulan Sorular
GPU'ların yüzde 60'ının boşa gitmesinin temel nedeni nedir?
Büyük dil modeli çıkarımı sırasında GPU'lar, konuşma geçmişini KV önbelleğinde tutar. Ancak GPU belleği sınırlı olduğundan eski bağlam silinmek zorunda kalınır ve oturum yeniden başladığında GPU aynı geçmişi baştan hesaplar. WEKA Saha CTO'su Alan McSeveney'e göre herhangi bir strateji uygulanmadan çalışan bir GPU, yeni işler için yalnızca yüzde 30 kullanım oranına düşebilir.
NVMe flash, KV önbelleği için DRAM'e kıyasla neden tercih ediliyor?
McSeveney'e göre NVMe flash, KV önbelleğini tutma konusunda DRAM ile eşit ya da daha iyi performans sunuyor; buna ek olarak çok daha iyi ölçekleniyor ve maliyeti DRAM'den önemli ölçüde düşük. Bu durum onu sunucu DRAM kapasitesini genişletmeye kıyasla daha ekonomik bir seçenek haline getiriyor.
WEKA'nın Augmented Memory Grid çözümü nasıl çalışıyor?
NeuralMesh depolama yazılımı üzerinde çalışan Augmented Memory Grid, GPU sunucularından KV önbelleğini alıp merkezi olarak depoluyor ve veri merkezindeki herhangi bir sunucuya geri yükleyebiliyor. Bu sayede bir oturum bir sunucuda duraksayıp başka birinde devam edebiliyor; ikinci GPU'nun geçmişi yeniden hesaplaması gerekmiyor. McSeveney, bu yaklaşımın DRAM'e aktarımla karşılaştırıldığında aynı GPU'lar üzerindeki kullanıcı sayısını 7 kat artırdığını ve çıktıyı 200.000 tokenden 2 milyona yükselttiğini belirtti.
Token başına ücretlendirme modelinde önbelleklemenin avantajı kime kalıyor?
McSeveney'e göre önbelleklemenin getirdiği verimlilik kazanımı, GPU'yu kontrol eden tarafa yarıyor. Bir şirket temel model sağlayıcısına token başına ücret ödüyorsa sağlayıcı tarafındaki önbelleklemenin büyük bölümünden elde edilen kazanım o sağlayıcıya gidiyor. Kendi donanımını işleten ya da ham GPU örnekleri kiralayıp kendi yazılımını çalıştıran şirketler ise bu avantajdan doğrudan yararlanabiliyor.
GPU arzının daralması şirketlerin altyapı kararlarını nasıl etkiliyor?
McSeveney, Google'ın müşterilerine ilettiği mesajı örnek göstererek Google Cloud için sipariş edilen ancak henüz kurulmamış her GPU'nun hizmet ömrü boyunca zaten bir alıcısı olduğunu ve Aralık ayına kadar rezervasyon yaptırmayan müşterilerin talep üzerine kapasite bulmayı beklememesi gerektiğini aktardı. Aynı kısıtlı arzdan satın alan hizmet sağlayıcılarının da benzer bir sıkışıklıkla karşılaşacağını belirterek kendi altyapısını işletmenin bir zorunluluk haline gelebileceğini vurguladı.

 Siber Güvenlik
 Siber Güvenlik
 Siber Güvenlik
Yorumlar (0)
Yorum yapmak için giriş yapmalısınız.