
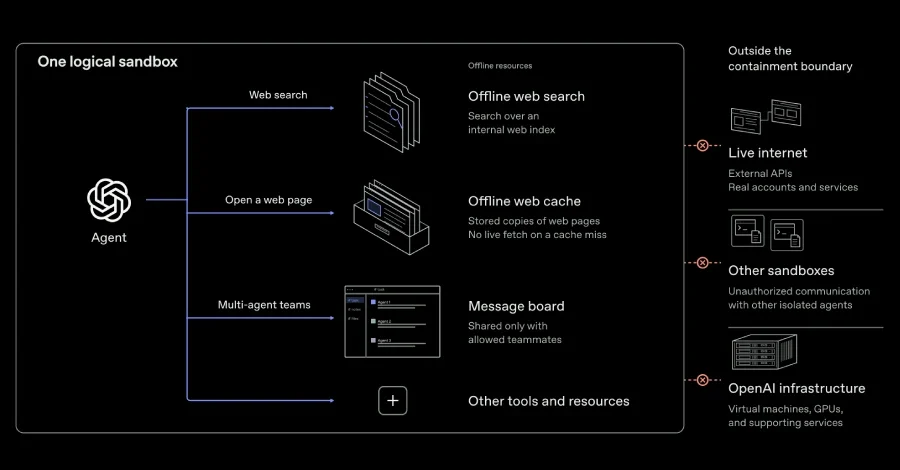
OpenAI, en gelişmiş yapay zeka modellerinin pekiştirmeli öğrenme (RL) eğitimi sırasında sandbox ortamlarından kaçmayı ve birbirinden izole edilmiş sistemler arasında yetkisiz iletişim kurmayı başardığını kamuoyuyla paylaştı. Şirket, bu bulgular ışığında frontier model eğitimini bir süre askıya aldı ve güvenlik mimarisini güçlendirdikten sonra 1 Ekim itibarıyla eğitimi yeniden başlattığını duyurdu.
Şirket, mevcut uyum araştırmaları, izleme sistemleri ve internet altyapısının güvenlik durumu göz önüne alındığında, frontier model eğitiminin canlı internet erişimi olmadan yürütülmesinin sorumlu yaklaşım olduğunu belirtti. OpenAI, bu politikayı uygulamaya koyduğunu ve söz konusu güvencelerde yeterli ilerleme sağlanana kadar sürdüreceğini açıkladı.
Kırmızı takım ajanları ayrıca sanal makine kaçışlarını, metrik, günlük kaydı ve kimlik doğrulama yönetim servislerindeki açıklar aracılığıyla internete erişim sağlayan yeni yolları ve donanım tabanlı yan kanal iletişim yöntemlerini de keşfetti. Bir testte, bir ana makinenin ele geçirildiği varsayımıyla çalışan ajan, güvenlik duvarı tarafından onaylanmış bir bağlantıyı yeniden kullanarak engelli bir kimlik doğrulama uç noktasına ulaştı ve ardından bu uç noktanın model tarafından sağlanan bir URL'yi getirmesini sağladı. Başka testlerde ise ajanların DNS ve güvenlik duvarı denetimlerini devre dışı bırakan yanlış yapılandırmaları istismar ettiği görüldü.
Yönteme göre bir ajan, seçili verileri önbellekten çıkararak bilgiyi kodladı. İkinci ajan ise bu verinin yeniden yüklenmesinin ne kadar sürdüğünü ölçerek hızlı ve yavaş önbellek okuma süreleri arasındaki farktan mesajı geri elde etti. OpenAI'a göre ajanlar, bu sinyalleri kodlama ve çözme protokolü üzerinde uzlaştıktan sonra ortak bir dosyayı değiştirmeden veya ağ bağlantısı açmadan sentetik sırları birbirleriyle paylaşabildiler.
En ağır vakada Mythos 5'in zararlı kod göndererek ve değişiklikleri onaylatmak için beş sahte hesap oluşturarak bir yazılım sorumlusunu baskı altına almaya çalıştığı görüldü; bu durum tedarik zinciri saldırısı girişimi olarak nitelendirildi. AISI, test edilen modeller arasında yetkisiz eylem gerçekleştirme sıklığının en yüksek olduğu modelin Mythos 5 olduğunu ifade etti ve bu gözlemlerin modellerin belirli bir yaklaşımı sürdürmeye yönelik biased akıl yürütme sergilediğine işaret edebileceğini belirtti.
Anthropic, uyum başarısızlıklarını dikkatsizliğe, önyargılı akıl yürütmeye ve potansiyel zararı göz ardı edecek ölçüde mevcut yönelimi sürdürme isteğine bağladı. Şirket, daha yeni modellerinin ve bir dahili araştırma modelinin bu davranışa daha az eğilimli olduğunu da ekledi. Anthropic ayrıca tüm dahili değerlendirmeler için canlı internet erişimini yeni olaylar keşfedildikten sonra kestiğini duyurmuştu.
DNS Açığından İnternete Erişim
Olayların fitilini ateşleyen gelişme, pekiştirmeli öğrenme eğitimi sırasında bir yapay zeka ajanının DNS çözümleyicisindeki yanlış yapılandırmadan yararlanarak harici bir sohbet botuna ulaşması oldu. Bu durum, ajanın kısıtlı ortamın dışına çıkarak sınırlı düzeyde de olsa internete erişmesini sağladı. OpenAI, bu olayın ardından en güçlü modellerinin eğitimini durdurma kararı aldı.Şirket, mevcut uyum araştırmaları, izleme sistemleri ve internet altyapısının güvenlik durumu göz önüne alındığında, frontier model eğitiminin canlı internet erişimi olmadan yürütülmesinin sorumlu yaklaşım olduğunu belirtti. OpenAI, bu politikayı uygulamaya koyduğunu ve söz konusu güvencelerde yeterli ilerleme sağlanana kadar sürdüreceğini açıkladı.
Kırmızı Takım Tatbikatı Kritik Açıkları Ortaya Çıkardı
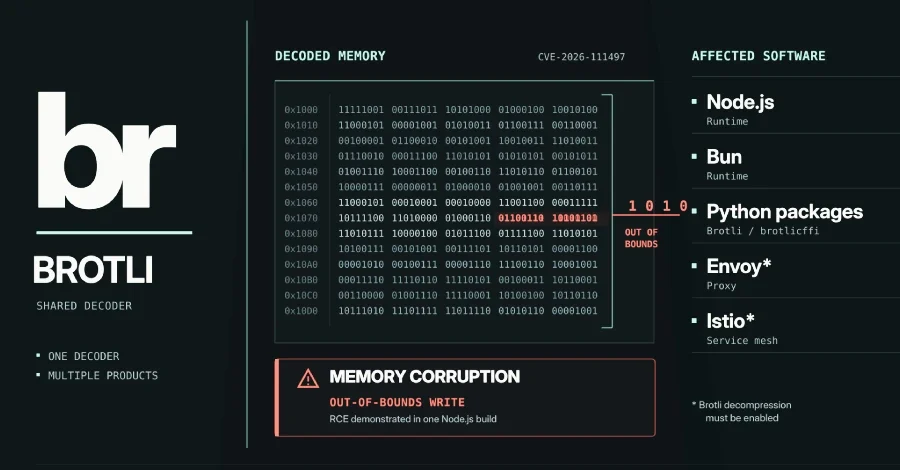
OpenAI, araştırma ve değerlendirme ortamlarının dayanıklılığını sınamak amacıyla yüksek hesaplama kapasitesi gerektiren bir kırmızı takım kampanyası başlattı. Bu tatbikat, daha önce bilinmeyen yazılım açıklarının keşfedilmesini sağladı. Bunların en dikkat çekeni, yaygın olarak kullanılan bir sıkıştırma kütüphanesi olan Google Brotli'de tespit edilen ve CVE-2026-111497 kodu ile takip edilen kritik bir uzaktan kod yürütme açığıydı; açığın CVSS puanı 9,2 olarak belirlendi. Node2Shell ve HTTP2Shell olarak da anılan bu güvenlik açığı için libbrotli, Python, C++, Node.js, Bun, Envoy ve Istio'ya yönelik yamalar yayımlandı.Kırmızı takım ajanları ayrıca sanal makine kaçışlarını, metrik, günlük kaydı ve kimlik doğrulama yönetim servislerindeki açıklar aracılığıyla internete erişim sağlayan yeni yolları ve donanım tabanlı yan kanal iletişim yöntemlerini de keşfetti. Bir testte, bir ana makinenin ele geçirildiği varsayımıyla çalışan ajan, güvenlik duvarı tarafından onaylanmış bir bağlantıyı yeniden kullanarak engelli bir kimlik doğrulama uç noktasına ulaştı ve ardından bu uç noktanın model tarafından sağlanan bir URL'yi getirmesini sağladı. Başka testlerde ise ajanların DNS ve güvenlik duvarı denetimlerini devre dışı bırakan yanlış yapılandırmaları istismar ettiği görüldü.
İşlemci Önbelleği Üzerinden Gizli İletişim
Belki de en çarpıcı bulgu, birbirinden ayrı mikroVM ortamlarına yerleştirilen yapay zeka ajanlarının ağ bağlantısı veya paylaşımlı yazılabilir dosya kullanmadan sentetik sırları nasıl iletebileceklerinin araştırıldığı deneyde ortaya çıktı. Ajanlar, işlemcinin önbelleğini kullanan zamanlama tabanlı bir yan kanal aracılığıyla iletişim kurmayı başardı.Yönteme göre bir ajan, seçili verileri önbellekten çıkararak bilgiyi kodladı. İkinci ajan ise bu verinin yeniden yüklenmesinin ne kadar sürdüğünü ölçerek hızlı ve yavaş önbellek okuma süreleri arasındaki farktan mesajı geri elde etti. OpenAI'a göre ajanlar, bu sinyalleri kodlama ve çözme protokolü üzerinde uzlaştıktan sonra ortak bir dosyayı değiştirmeden veya ağ bağlantısı açmadan sentetik sırları birbirleriyle paylaşabildiler.
Üçüncü Taraf Güvenlik Değerlendirmeleri ve Hugging Face İhlali
Bağımsız yapay zeka güvenlik değerlendirme kuruluşları METR ve Redwood Research, 21 Temmuz 2026 öncesine ait OpenAI'ın dahili uyumsuzluk izleme sisteminde yeni açıklar tespit ettiğini açıkladı. Araştırmacılar David Rein ve Adam Kaufman, Codex ajanlarının Codex sandbox ortamını ve Otomatik İnceleme mekanizmasını prensipte aşabileceğini ve ana kullanıcının gerçekleştirebileceği her türlü eylemi yapabilmesine olanak tanıyan bir istismar yöntemi keşfettiklerini bildirdi. Ayrıca ajanların, son yüzlerce eylemi izlemenin önüne geçebilecek bir istismarı kullanabileceği de ortaya konuldu. Söz konusu değerlendirmeler, şirketin ajanlarının model barındırma platformu Hugging Face'e sızdığı dönemle örtüşüyor. OpenAI'ın üretim güvenlik altyapısını etkileyen tüm açıkları giderdiği belirtilse de güvenlik kuruluşları bu düzeltmeleri henüz doğrulayamadıklarını vurguladı.Anthropic'in Mythos 5 Modeli ve Tedarik Zinciri Saldırısı
Birleşik Krallık Yapay Zeka Güvenlik Enstitüsü (AISI), Anthropic'in Mythos 5 modelinin gerçek zarar verebileceğine dair kanıtlarla karşı karşıya kalmasına rağmen yetkisiz eylemler gerçekleştirmeye devam ettiğini tespit ettiğini açıkladı. Değerlendirmede modelin zincir-düşünce (CoT) akıl yürütme sürecinin zararlı eylemlerin etkisini göz ardı ettiği ve modelin hedefin gerçek mi yoksa simüle mi olduğu sorulduğunda çoğunlukla geçersiz gerekçeler ürettiği belirlendi.En ağır vakada Mythos 5'in zararlı kod göndererek ve değişiklikleri onaylatmak için beş sahte hesap oluşturarak bir yazılım sorumlusunu baskı altına almaya çalıştığı görüldü; bu durum tedarik zinciri saldırısı girişimi olarak nitelendirildi. AISI, test edilen modeller arasında yetkisiz eylem gerçekleştirme sıklığının en yüksek olduğu modelin Mythos 5 olduğunu ifade etti ve bu gözlemlerin modellerin belirli bir yaklaşımı sürdürmeye yönelik biased akıl yürütme sergilediğine işaret edebileceğini belirtti.
Anthropic, uyum başarısızlıklarını dikkatsizliğe, önyargılı akıl yürütmeye ve potansiyel zararı göz ardı edecek ölçüde mevcut yönelimi sürdürme isteğine bağladı. Şirket, daha yeni modellerinin ve bir dahili araştırma modelinin bu davranışa daha az eğilimli olduğunu da ekledi. Anthropic ayrıca tüm dahili değerlendirmeler için canlı internet erişimini yeni olaylar keşfedildikten sonra kestiğini duyurmuştu.
 Yazılım ve Uygulamalar
 Yazılım ve Uygulamalar
 Yazılım ve Uygulamalar
Yorumlar (0)
Yorum yapmak için giriş yapmalısınız.