
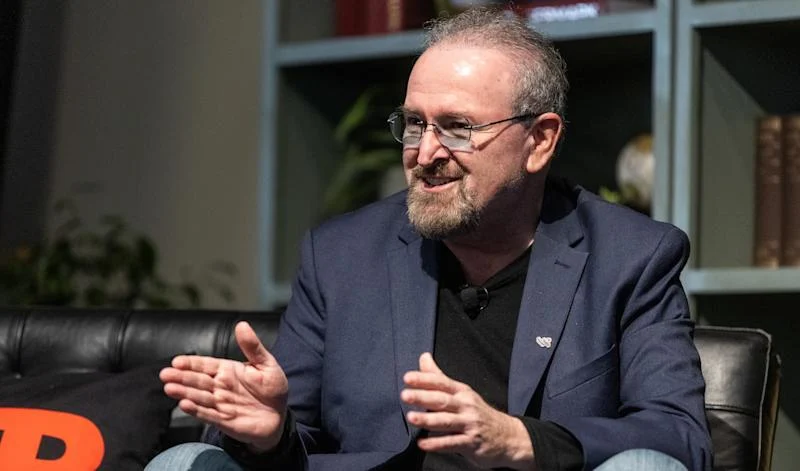
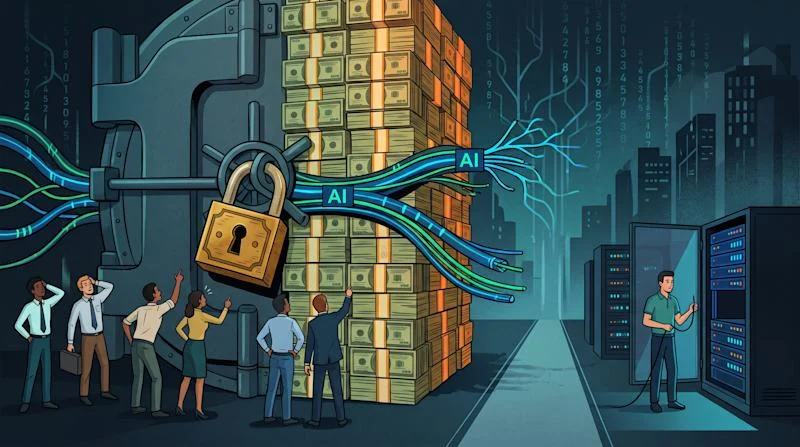
WEKA'nın baş AI sorumlusu Val Bercovici, kurumsal düzeyde çalışan çoklu yapay zekâ (AI) ajan sistemlerinin başarıyı ölçmek için GPU kapasitesini veya token sayısını değil, her bir tamamlanmış iş için ortaya çıkan net maliyeti esas alması gerektiğini savunuyor. Bercovici, şirketlerin yüksek maliyetle daha fazla grafik işleme birimi (GPU) almasının temel nedenlerinden birinin, modellerin kısa süreli hafızası olan KV önbelleğini yeniden hesaplamak zorunda kalması olduğunu belirtti. Bu sorunun çözümü için şirketlerin, bu çalışma hafızasını GPU belleğinin dışında, paylaşımlı ve hızlı bir depolama katmanında tutması gerektiğini önerdi.
İkinci neden ise KV önbelleğinin yeniden hesaplanması. Bir dil modeli bir istem (prompt) üzerinde çalışırken dikkat mekanizması için kritik olan anahtar-değer (key-value) çiftlerini ürettiği KV önbelleğini oluşturuyor. Bu önbellek, GPU'nun yüksek bant genişliğine sahip belleğinden (HBM) taşarsa, sıradaki ajanın bu bağlamı baştan yeniden hesaplamak zorunda kalması ortaya çıkıyor. Bercovici, "Birincil kural aynı token'ı iki kez yeniden hesaplamamaktır. İstem hazırlığını (prefill) iki kez yapmayın" uyarısını yaptı.
Bercovici, donanım sınırlamaları altındaki Çinli araştırma laboratuvarlarının daha sıkı tasarımlar geliştirme zorunluluğundan etkilendiğini, ancak Amerika Birleşik Devletleri'ndeki özellikle Silikon Vadisi şirketlerinin ise "daha fazla donanım" varsayımıyla hareket ettiğini ifade etti. Bu yaklaşımın maliyetini, son dönemde rakiplerin per-token fiyatlarını düşürmesiyle artan DeepSeek'in rekabeti de belirgin biçimde gündeme getirmiş durumda.
Neden daha fazla GPU ve token tek başına etkili değil
Bercovici, VentureBeat kurucusu Matt Marshall ile VB Agentic Infrastructure Stack Summit etkinliğinde yaptığı konuşmada, kurumsal AI bütçelerinin iki ana nedenle gereğinden fazla şiştiklerini aktardı. Bunlardan ilki, model sağlayıcıları ve müşterilerin hâlâ hizmet bedelini tüketilen token sayısına göre belirlemesi. Bu yöntem, tek bir ajanla verimli biçimde tamamlanabilen işleri çoğu zaman maliyet açısından daha az kârlı hale getirebilen çoklu ajan takımlarının daha pahalı görünmesine yol açıyor.İkinci neden ise KV önbelleğinin yeniden hesaplanması. Bir dil modeli bir istem (prompt) üzerinde çalışırken dikkat mekanizması için kritik olan anahtar-değer (key-value) çiftlerini ürettiği KV önbelleğini oluşturuyor. Bu önbellek, GPU'nun yüksek bant genişliğine sahip belleğinden (HBM) taşarsa, sıradaki ajanın bu bağlamı baştan yeniden hesaplamak zorunda kalması ortaya çıkıyor. Bercovici, "Birincil kural aynı token'ı iki kez yeniden hesaplamamaktır. İstem hazırlığını (prefill) iki kez yapmayın" uyarısını yaptı.
Soğuk savaşı (Black October) ve daimi hafıza ihtiyacı
Bercovici, üretim ortamlarında asla tekil ajanlardan değil, sürekli çoğul çalışan sistemlerden söz edilebildiğini belirtiyor. Ajanlar arası devrelerde kısa süreli hafıza olarak KV önbelleği, uzun süreli hafıza olarak ise önceki oturumlardan kalan bağlam kritik önem taşır. Son dönemde "Black October" olarak adlandırılan ve 20 yıllık eski bir PHP açıklamasını istismar eden siber saldırı dalgasında, saldırganların daimi çalışan otomatik ajanlar kullandığı tespit edildi. Bu, savunma tarafındaki şirketlerin de kendi sistemlerini arka planda sürekli işletilen kendi ajanlarıyla koruması gerekliliğini doğuruyor; böylece çalışma hafızası günün her saatinde talepte kalıyor ve kümeler bu bilgiyi yeniden inşa etmek için boşluk bulamıyor.Paylaşımlı depolama ve donanım verimliliği
Bercovici, GPU HBM kapasitesi ve Cerebras'ın çip üzerindeki SRAM depolamasını "gezegendeki en pahalı gayrimenkul" olarak nitelendirdi. Şirketlerin uzun bağlam gereksinimleri karşısında kullanmadıkları hesaplama kapasitesi için gereksiz yere ödeme yaptığını vurguladı. Sözü edilen çözüm, KV önbelleğini bu pahalı katmanın dışında tutarak paylaşımlı flaş depolamaya aktarmak. Bu yapı, uygun sistemlerin daha önce hesaplanmış durumu yeniden yüklemesini sağlayarak GPU'lara yeni token'lar üzerinde çalışma esnekliği veriyor. DeepSeek'in 100 PB'lık küme altyapısı, bu tür "işleyen bellek" talebinin ne kadar büyük boyutlara ulaştığını gösteriyor.Bercovici, donanım sınırlamaları altındaki Çinli araştırma laboratuvarlarının daha sıkı tasarımlar geliştirme zorunluluğundan etkilendiğini, ancak Amerika Birleşik Devletleri'ndeki özellikle Silikon Vadisi şirketlerinin ise "daha fazla donanım" varsayımıyla hareket ettiğini ifade etti. Bu yaklaşımın maliyetini, son dönemde rakiplerin per-token fiyatlarını düşürmesiyle artan DeepSeek'in rekabeti de belirgin biçimde gündeme getirmiş durumda.
 Siber Güvenlik
 Siber Güvenlik
 Siber Güvenlik
Yorumlar (0)
Yorum yapmak için giriş yapmalısınız.